Yapay zekâ ile kod yazmanın en büyük problemlerinden biri artık yapay zekânın kod yazamaması değil.
Tam tersine.
Bugün Claude Code, Codex, Cursor ve benzeri araçlara yeterince düzgün bir görev verdiğinizde binlerce satırlık kod ürettirebiliyorsunuz.
Asıl problem başka bir yerde başlıyor:
Yapay zekâ yazılım projenizi gerçekten anlayabiliyor mu?
Bir dosyayı anlamak kolay.
İki dosyayı anlamak da kolay.
Ama proje büyüdüğünde olay şöyle bir hale geliyor:
index.php
   ↓
bootstrap.php
   ↓
AuthService.php
   ↓
UserRepository.php
   ↓
database.php
   ↓
MySQL

aynı zamanda

AuthService.php
   ↓
SessionManager.php
   ↓
Redis

ve

UserRepository.php
   ↓
NotificationService.php
   ↓
Queue
Bir fonksiyonu değiştirdiğiniz zaman sistemin başka hangi parçalarının etkilendiğini anlamak artık yalnızca dosyayı okumakla mümkün olmuyor.
İnsan geliştirici zaman içerisinde projenin zihinsel bir haritasını oluşturuyor.
Yapay zekâ ise çoğu zaman her yeni oturumda bunu yeniden yapmak zorunda kalıyor.
Graphify tam olarak bu probleme saldırıyor.
Graphify nedir?
Graphify, kod tabanınızı ve proje belgelerinizi bir knowledge graph — bilgi grafiğine dönüştüren açık kaynaklı bir araç.
Basitleştirirsek normal bir AI coding agent projeye şöyle bakıyor:
Dosya
Dosya
Dosya
Dosya
Dosya
Graphify ise aynı projeye şöyle bakmaya çalışıyor:
UserController
      │
    calls
      ↓
UserService
      │
   depends_on
      ↓
UserRepository
      │
   queries
      ↓
users table
Yani Graphify için önemli olan yalnızca:
“Bu kod hangi dosyada?”
sorusu değil.
Daha önemli olan:
“Bu şey diğer şeylerle nasıl bağlantılı?”
sorusu.
Graphify Labs ürünü bunu AI coding assistant’ları için bir code knowledge graph olarak tanımlıyor. Araç kod, dokümantasyon, SQL şemaları, konfigürasyonlar ve bazı medya türlerini aynı graph içerisinde ilişkilendirebiliyor.
Peki Claude Code normalde projeyi nasıl anlıyor?
Claude Code'a:
Kullanıcı login olduğunda hangi işlemler gerçekleşiyor?diye sorduğunuzu düşünelim.
Eğer proje hakkında önceden yeterli context yoksa agent kabaca şöyle çalışabilir:
grep "login"
       ↓
ilgili dosyaları bul
       ↓
dosyaları aç
       ↓
fonksiyonları oku
       ↓
başka fonksiyonları fark et
       ↓
onları ara
       ↓
başka dosyaları aç
       ↓
ilişkiyi kafasında kur
Bu yöntem kötü değil.
Küçük projelerde gayet iyi çalışıyor.
Ama 500, 2.000 veya 10.000 dosyalık bir projede problem çıkmaya başlıyor.
Çünkü her soruda agent'ın projenin bir bölümünü tekrar keşfetmesi gerekiyor.
Graphify'ın temel fikri şu:
Projeyi her soruda yeniden keşfetme. Bir kere haritasını çıkar ve sonra haritayı sorgula.
Graphify'ın kendi anlatımında da hedef tam olarak bu: agent'ın her seferinde raw dosyalarda grep yapması yerine daha önce oluşturulmuş graph üzerinde gezinmesi.
Graphify nasıl çalışıyor?
Burada işin teknik tarafı ilginçleşiyor.
Graphify yalnızca bütün dosyaları bir LLM'e gönderip:
“Bana bunun mimarisini anlat.”
demiyor.
Kod tarafında mümkün olduğunca deterministik davranmaya çalışıyor.
Temel pipeline'ı basitleştirirsek:
Proje Dosyaları
       ↓
Dosya türlerini tespit et
       ↓
Tree-sitter AST analizi
       ↓
Fonksiyonlar / Class'lar / Import'lar / Calls
       ↓
Node + Edge üretimi
       ↓
NetworkX Graph
       ↓
Leiden Community Detection
       ↓
graph.json
GRAPH_REPORT.md
graph.html
Kod dosyaları tree-sitter ile parse ediliyor.
Bu önemli.
Çünkü kodun:
$userService->login($email, $password);satırına yalnızca düz metin olarak bakmak yerine AST üzerinden bunun bir fonksiyon/metot çağrısı olduğu anlaşılabiliyor.
Graphify'ın güncel açık kaynak deposunda kod tarafında yaklaşık 37 tree-sitter grammar desteği bulunuyor; PHP, JavaScript, TypeScript, Python, Go, Rust, Java, C/C++, C#, Kotlin, Swift, Lua, PowerShell, SQL ve çok sayıda başka format destekleniyor.
AST neden önemli?
Mesela elimizde şu kod olsun:
class UserController
{
    public function login()
    {
        return $this->authService->authenticate();
    }
}
Düz metin araması:
authenticatekelimesinin nerelerde geçtiğini bulabilir.
Ama AST sistemi bunun:
UserController.login
        ↓ calls
AuthService.authenticate
ilişkisi olduğunu çıkarabilir.
Graph mantığı için bu çok daha değerli.
Çünkü artık elimizde yalnızca dosyalar değil:
ilişkiler
var.
Graph'ın içinde ne bulunuyor?
Basitleştirilmiş bir Graphify çıktısını şöyle düşünebilirsiniz:
[LoginController]
       |
       | calls
       ↓
[AuthService]
       |
       | uses
       ↓
[UserRepository]
       |
       | queries
       ↓
[users]
Başka bir tarafta:
[AuthService]
       |
       | depends_on
       ↓
[SessionManager]
Ve:
[SessionManager]
       |
       | writes
       ↓
[Redis]
Artık agent şunu sorabilir:
LoginController ile Redis arasında nasıl bir bağlantı var?Ve bütün dosyaları tekrar okumak yerine graph üzerinde yol arayabilir.
LoginController
   ↓
AuthService
   ↓
SessionManager
   ↓
Redis
Graphify bunun için doğrudan path sorguları sunuyor. Ayrıca query ve explain komutlarıyla belirli bir yapı veya node hakkında graph üzerinden bilgi alınabiliyor.
Graphify'ın ürettiği üç temel dosya
Projede:
/graphify .çalıştırıldığında temel çıktılar graphify-out klasörüne yazılıyor.
graphify-out/
│
├── graph.html
├── GRAPH_REPORT.md
└── graph.json
Bunların üçü de farklı işe yarıyor.
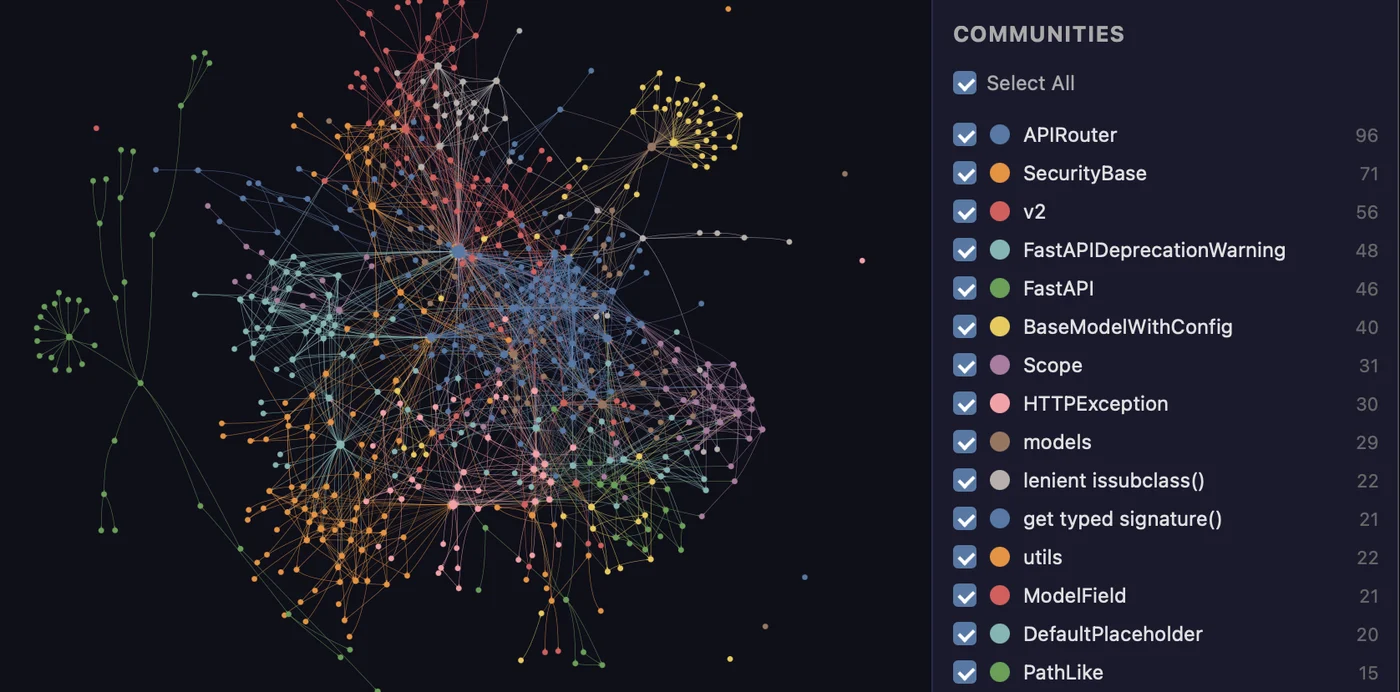
graph.html
Projenin görsel haritası.
Node'ları ve aralarındaki bağlantıları tarayıcı üzerinden görebiliyorsunuz.
Örneğin:
● Auth
  ├── LoginController
  ├── SessionManager
  └── TokenService

● Database
  ├── UserRepository
  ├── ProductRepository
  └── DatabaseConnection
gibi kümeler oluşabilir.
Büyük node'lar genellikle sistem içerisinde çok sayıda başka parçayla bağlantısı bulunan önemli yapıları temsil eder.
Graphify bunlara god nodes adını veriyor.
God Node nedir?
Diyelim ki projenizde:
Database.phpdosyasına 73 farklı servis bağlı.
Graph açısından bu node'un degree değeri oldukça yüksek olur.
Bu size önemli bir bilgi verir:
Bu dosyayı değiştirirken dikkat et.
Çünkü küçük bir değişikliğin blast radius'u büyük olabilir.
Örneğin:
DatabaseConnection
      │
 ┌────┼────┬────┬────┐
 ↓    ↓    ↓    ↓    ↓
Auth Order Mail User Payment
Böyle bir yapı görürseniz DatabaseConnection'ın projenin kritik merkezlerinden biri olduğunu daha kodu tek tek okumadan anlayabilirsiniz.
Graphify'ın “god node” özelliğinin temel mantığı bu.
Community Detection
Graphify yalnızca bağlantıları çıkarmıyor.
Aynı zamanda birbirine yoğun şekilde bağlı node'ları otomatik olarak gruplandırmaya çalışıyor.
Burada Leiden community detection algoritması kullanılıyor.
Örneğin yüzlerce dosyalık bir projede graph şu toplulukları fark edebilir:
AUTH COMMUNITY
├── LoginController
├── AuthService
├── SessionManager
└── TokenService


PAYMENT COMMUNITY
├── PaymentController
├── StripeService
├── InvoiceService
└── OrderRepository


CONTENT COMMUNITY
├── PostController
├── MediaService
└── StorageService
Siz bu modülleri özel olarak tanımlamasanız bile graph topolojisi üzerinden birbirine sıkı bağlı bölgeler ortaya çıkarılabiliyor.
Buradaki önemli detay:
Graphify bunu klasik embedding similarity üzerinden yapmıyor.
Graph bağlantı yoğunluğunu kullanıyor.
Graphify bir Vector Database değil
Bence Graphify'ı anlamak için en önemli ayrımlardan biri bu.
Bugünkü birçok RAG sistemi şöyle çalışıyor:
Doküman
   ↓
Chunk
   ↓
Embedding
   ↓
Vector Database
   ↓
Similarity Search
Siz:
Authentication sistemi nasıl çalışıyor?diye sorunca sistem sorunuza semantik olarak benzeyen parçaları getiriyor.
Ama benzerlik:
bağlantı
demek değildir.
İki kod parçası semantik olarak birbirine benzemeyebilir ama teknik olarak birbirine doğrudan bağlı olabilir.
Graph yaklaşımında soru şu:
A hangi node'a bağlı?
B'ye hangi path üzerinden ulaşıyor?
Bunu kim çağırıyor?
Bunun değişmesi kimi etkiliyor?
Graphify'ın tasarım felsefesi bu nedenle:
similarity yerine structure
üzerine kurulu. Şirket de açıkça embedding veya vector store zorunluluğu olmadan graph traversal yaptığını belirtiyor.
EXTRACTED ve INFERRED meselesi
Graphify'ın hoşuma giden taraflarından biri burada.
Bir AI size:
“Bu servis PaymentService'e bağlı.”
dediğinde şu soruyu sormanız gerekir:
Nereden çıkardın bunu?
Graphify ilişkileri kaynağına göre etiketlemeye çalışıyor.
Örneğin:
EXTRACTEDdoğrudan kaynakta görülen bağlantı.
Örneğin:
use PaymentService;veya gerçek bir function call.
Bir de:
INFERREDbulunuyor.
Bu ise sistemin mevcut kanıtlardan çıkardığı ilişki.
Bazı sürümlerde belirsiz ilişkiler için ayrıca AMBIGUOUS işaretlemesi de kullanılıyor.
Bu ayrım önemli çünkü:
AI söylediile:
Kodun içerisinde gerçekten bu bağlantı varaynı şey değil.
Graphify'ın temel vaatlerinden biri her edge'in nereden geldiğini gösterebilmek.
Peki dokümantasyon ne oluyor?
Kod AST ile çözülebilir.
Ama README?
PDF?
Mimari doküman?
Ekran görüntüsü?
Whiteboard?
Bunlarda AST yok.
Graphify burada semantic extraction kullanıyor.
Örneğin dokümanda:
Payment işlemleri tamamlandıktan sonra
NotificationService üzerinden kullanıcıya
bildirim gönderilir.
yazıyorsa model bundan:
PaymentService
      ↓ triggers
NotificationService
gibi semantik bir ilişki çıkarabilir.
Graphify kod ile doküman ilişkilerini aynı graph altında birleştirmeye çalışıyor.
Güncel sürüm ayrıca PDF, Office dosyaları, görseller ve isteğe bağlı olarak video/audio gibi veri türlerini de destekliyor. Video/audio için local faster-whisper desteği bulunuyor.
Bu noktada Graphify yalnızca:
Code Graph
olmaktan çıkıp:
Project Knowledge Graph
haline geliyor.
Gizlilik tarafı önemli
Burada internette biraz yanlış anlatılan bir konu var.
Bazen Graphify için:
“Hiçbir veri bilgisayarınızdan çıkmıyor.”
deniyor.
Bu yalnızca belirli kullanım biçimleri için tamamen doğru.
Kod tarafı tree-sitter ile lokal olarak analiz edilebiliyor.
Yani code-only extraction yaptığınızda kodunuzu bir LLM'e göndermek zorunda değilsiniz.
Ancak doküman, PDF veya görsel gibi semantik analiz gereken içerikleri kullandığınızda seçtiğiniz AI sağlayıcısına veri gönderilebilir.
Graphify; Claude, OpenAI, Gemini, DeepSeek, Bedrock ve Ollama dahil farklı backend'leri destekliyor. Ollama kullanırsanız semantic extraction tarafını da lokal tutmak mümkün.
Dolayısıyla:
Code only
→ Tamamen local çalışabilir

Code + docs + images
→ Seçilen modele göre dış API kullanılabilir
ayrımını bilmek gerekiyor.
Claude Code ile asıl entegrasyon nasıl oluyor?
Graph oluşturmak tek başına yeterli değil.
Çünkü graph orada dururken Claude Code yine gidip her şeyi grep ile arayabilir.
Graphify'ın Claude Code entegrasyonu burada devreye giriyor.
Kurulum:
uv tool install graphifyy
graphify install
Ardından Claude Code içerisinde:
/graphify .çalıştırılabiliyor.
Graphify'ın Claude entegrasyonu CLAUDE.md içerisine Graphify kullanım talimatlarını ekleyebiliyor ve bir PreToolUse hook kurabiliyor.
Bu hook Claude Glob veya Grep gibi araçlara yönelmeden önce ona kabaca:
Bu projede Graphify knowledge graph mevcut.
Önce graph üzerinden kontrol et.
hatırlatması yapıyor.
Bu ufak detay aslında sistemin en önemli parçalarından biri.
Çünkü:
Graph oluşturuldubaşka şey.
Agent gerçekten graph'ı kullanıyorbaşka şey.
MCP burada neden önemli?
Graphify ayrıca MCP server olarak çalışabiliyor.
Örneğin:
python -m graphify.serve graphify-out/graph.jsonile graph'ı MCP üzerinden expose edebiliyorsunuz.
Agent daha sonra:
query_graph
get_node
get_neighbors
shortest_path
gibi yapılandırılmış işlemler yapabiliyor.
Bence MCP entegrasyonu Graphify'ın en önemli parçalarından biri.
Çünkü artık graph yalnızca Claude Code'a özel olmuyor.
Aynı graph:
Claude Code
      │
Cursor│
      │
Codex ├────→ Graphify MCP
      │
Gemini│
      │
Copilot
tarafından kullanılabilir.
Yani farklı coding agent'lar aynı proje hafızasını paylaşabilir.
Graphify + Claude Code Agent Teams
Burada özellikle bir yanlış anlaşılmayı düzeltmek gerekiyor.
Graphify Agent Teams değildir.
Graphify kendi başına:
Frontend Agent
Backend Agent
Database Agent
Tester Agent
oluşturup projenizi geliştiren bir takım yöneticisi değildir.
Graphify:
takımın kullandığı haritadır.
Claude Code Agent Teams ise birden fazla Claude Code session'ının aynı görev üzerinde koordineli şekilde çalışmasını sağlayan ayrı bir sistem.
Anthropic Agent Teams'i hâlâ deneysel özellik olarak tanımlıyor ve:
CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1ile etkinleştirilebiliyor. Her teammate'in kendi context window'u bulunuyor; ortak görev listesi üzerinden çalışabiliyor ve birbirleriyle mesajlaşabiliyorlar.
İkisini birlikte düşünelim.
Graphify olmadan:
              Lead Agent
                  │
       ┌──────────┼──────────┐
       ↓          ↓          ↓
 Backend      Frontend      Tests
 Agent         Agent        Agent
   │             │            │
grep repo     grep repo     grep repo
   │             │            │
context       context      context
Her agent aynı projeyi ayrı ayrı keşfetmeye başlayabilir.
Graphify ile:
                 Lead Agent
                     │
            ┌────────┼────────┐
            ↓        ↓        ↓
         Backend  Frontend   Tests
            │        │        │
            └────────┼────────┘
                     ↓
              GRAPHIFY GRAPH
                     │
        ┌────────────┼────────────┐
        ↓            ↓            ↓
      Code         Docs         SQL
Bütün agent'ların başvurabileceği ortak bir mimari harita ortaya çıkıyor.
Bence Graphify'ın multi-agent sistemlerde en anlamlı kullanım biçimlerinden biri bu.
Örneğin gerçek projede ne işe yarar?
Diyelim ki büyük bir PHP/MySQL projeniz var.
Claude'a şunu söylediniz:
User sistemi tamamen role-based permission
mimarisine geçirilecek.
Agent Teams kullanıyorsunuz.
Lead agent görevleri ayırıyor:
Agent 1:
Mevcut authentication sistemini analiz et.

Agent 2:
Database tablolarını ve ilişkileri analiz et.

Agent 3:
Frontend'deki permission kontrollerini bul.

Agent 4:
Testleri ve güvenlik risklerini incele.
Normalde dört agent da projeyi ayrı ayrı tarayabilir.
Graphify graph mevcutsa agent'lar önce şunları sorgulayabilir:
User modeline bağlı bütün yapıları göster.

AuthService'den hangi controller'lara path var?

users tablosuna dokunan servisler hangileri?

role alanını kullanan bütün node'ları getir.
Bu özellikle büyük projelerde ciddi fark yaratabilir.
“Blast Radius” analizi
Graph tabanlı yaklaşımın benim en mantıklı bulduğum özelliklerinden biri bu.
Diyelim:
UserRepository::findById()fonksiyonunu değiştireceksiniz.
Normalde:
grep findByIdyapabilirsiniz.
Ama daha karmaşık sistemlerde dolaylı bağımlılıklar olabilir.
Graph üzerinde:
findById
  ↓
UserService
  ↓
AuthService
  ↓
LoginController
  ↓
API
path'leri takip edilebilir.
Dolayısıyla sorunuz:
“Bu fonksiyonu değiştirirsem ne bozulabilir?”
haline geldiğinde knowledge graph oldukça doğal bir veri yapısı haline geliyor.
Graphify da platform ekipleri için özellikle change impact ve blast-radius kullanımını öne çıkarıyor.
Token tasarrufu gerçekten 70 kat mı?
Graphify'ın en çok konuşulan iddialarından biri:
71,5× daha az token.
Bu sayı Graphify'ın kendi worked-example testlerinden geliyor.
52 dosyalık kod, paper ve image corpusunda ham dosyaları tekrar okumakla graph üzerinden sorgulama arasında yaklaşık 71,5 katlık token farkı ölçülmüş.
Ancak küçük bir corpus üzerinde bu fark yaklaşık 1× seviyesine kadar düşebiliyor. Graphify'ın kendi örnekleri de tasarrufun corpus büyüklüğüyle arttığını gösteriyor.
Burada dikkat edilmesi gereken nokta şu:
“Graphify Claude kullanımınızı her durumda 71 kat azaltır.”
demek yanlış.
Bağımsız bir üretim testinde aynı feature'lar Graphify ve klasik grep/file-read yaklaşımıyla geliştirilmiş ve araştırmacılar session seviyesinde Graphify'ın 71× gibi dramatik bir tasarruf sağlamadığını belirtmiş.
Graphify bazı mimari sorularda ciddi avantaj sağlarken gerçek feature geliştirmede agent yine kod dosyalarını okumak zorunda kalabiliyor.
Bence doğru yorum şu:
Graphify
≠
Kod dosyalarını artık hiç okumamak

Graphify
=
Hangi kodu okuman gerektiğini daha hızlı bulmak
Asıl değer burada.
Çünkü AI sonunda yine gerçek kodu okumalı
Graphify'ın oluşturduğu graph:
source of truth değildir.
Source of truth hâlâ kodun kendisidir.
Graph size:
Buraya bak.
Bu iki şey bağlantılı.
Şu servis kritik.
Bu değişiklik buraya kadar ulaşabilir.
der.
Ama agent gerçek değişikliği yapmadan önce ilgili kodu açıp kontrol etmelidir.
Bu nedenle ideal akış bana göre:
Graph
  ↓
Relevant region
  ↓
Raw source
  ↓
Reason
  ↓
Edit
  ↓
Test
şeklinde.
Graph:
navigator.
Kod:
gerçek dünya.
Graph'ın güncel kalması gerekiyor
Burada Graphify'ın doğal bir problemi var.
Bugün graph oluşturdunuz.
Sonra üç gün boyunca kod değiştirdiniz.
Ama graph'ı güncellemediniz.
Agent:
Eski dünya haritasıyla
yeni dünyada dolaşıyor.
Graphify bunun için incremental update mekanizması ve cache sistemi kullanıyor.
/graphify . --updateile değişmiş dosyaların yeniden işlenmesi mümkün.
Cache tarafında SHA256 tabanlı değişiklik takibi bulunuyor.
Büyük projelerde full graph'ı her seferinde yeniden çıkarmak yerine bu yaklaşım oldukça önemli.
Graphify'ın zayıf olduğu yerler
Graph fikri güzel ama sihirli değil.
Özellikle dinamik dillerde runtime sırasında oluşturulan ilişkiler AST üzerinden her zaman kusursuz bulunamayabilir.
Örneğin:
$className = $_ENV['SERVICE_CLASS'];

$service = new $className();
gibi dinamik davranışların kesin dependency graph'ını statik analizle bulmak zorlaşabilir.
Reflection,
dependency injection,
magic methods,
runtime configuration,
event bus,
queue sistemleri
gibi yapılar graph'ın gerçek sistem davranışını birebir temsil etmesini zorlaştırabilir.
Bir diğer problem:
INFERRED edge'ler yanlış olabilir.
Bir LLM dokümandan ilişki çıkarıyorsa klasik model hataları tamamen ortadan kalkmış değildir.
Bu yüzden Graphify'ın EXTRACTED ve INFERRED ayrımı önemli.
Bir başka problem: Graph Spaghetti
500 node gayet güzel görünebilir.
5.000 node biraz karışık.
50.000 node olduğunda:
████████████████████
████████████████████
████████████████████
gibi anlamsız bir yıldız haritasına dönüşme riski var.
Bu yüzden büyük graph'larda görsel graph.html'den çok:
query
path
explain
community
gibi sorgular daha değerli hale geliyor.
Knowledge graph'ın amacı her node'u insan gözüyle tek tek incelemek değil.
Agent'ın doğru bölgeye ulaşmasını sağlamak.
Küçük projelerde Graphify gerekli mi?
Bana göre hayır.
Mesela:
index.php
style.css
script.js
database.php
olan bir projede Graphify kurmanın fazla anlamı yok.
Claude zaten dört dosyayı birkaç saniyede okuyabilir.
Graph'ın oluşturulması ve yönetilmesi ekstra katman ekler.
Graphify'ın değeri proje büyüdükçe ortaya çıkıyor.
Özellikle:
yüzlerce dosya

birden fazla servis

karmaşık database yapısı

çok sayıda dependency

legacy code

birden fazla geliştirici

birden fazla AI agent
olduğunda.
Graphify'ın kendi benchmarklarında da küçük corpuslarda token avantajının çok düşük, corpus büyüdükçe ise çok daha yüksek olması bunu destekliyor.
Graphify bana göre neden önemli?
Graphify'ın kendisinden ziyade temsil ettiği fikir bence önemli.
Bugünkü AI coding sistemlerinin önemli kısmı şu şekilde çalışıyor:
LLM
 ↓
Search
 ↓
Read files
 ↓
Reason
 ↓
Write code
Ama geleceğin agent sistemlerinde bunun şöyle olması daha mantıklı olabilir:
              Knowledge Graph
                    ↑
                    │
Code ───────────────┤
Docs ───────────────┤
Database ───────────┤
Architecture ───────┤
                    │
                    ↓
                 Router
                    │
       ┌────────────┼────────────┐
       ↓            ↓            ↓
 Backend Agent  Frontend Agent  Test Agent
Yani AI'a yalnızca:
dosya erişimi
değil,
sistem modeli
vermek.
AI coding'deki gerçek darboğaz değişiyor
Eskiden problem:
“AI kod yazabilir mi?”
idi.
Artık Claude, Codex ve diğer modeller bunu fazlasıyla yapabiliyor.
Yeni problem:
“AI yüz bin satırlık yazılımın tamamını anlayabilir mi?”
1 milyon token context window bile bu problemi tamamen çözmüyor.
Çünkü context büyüdükçe:
- maliyet artıyor,
- latency artıyor,
- gereksiz bilgi artıyor,
- önemli bilginin bulunması zorlaşıyor.
Her şeyi context'e koymak ile doğru şeyi context'e koymak aynı şey değil.
Graphify ikinci yaklaşımı deniyor.
Bence Graphify'ın asıl değeri “Memory”
Bir coding agent düşünün.
Bugün projeyi inceledi.
Authentication sistemini öğrendi.
Payment sistemini öğrendi.
Queue yapısını çözdü.
Sonra session bitti.
Yarın yeni session:
Merhaba.
Projeyi tekrar inceleyeyim.
Bu verimsiz.
İnsan geliştirici böyle çalışmıyor.
İnsan zaman içerisinde proje hakkında:
Auth buradan geçiyor.

Bu dosyaya dokunma, her şey buna bağlı.

Payment buradan başlıyor.

Cron bunu tetikliyor.

Bu tablo legacy ama hâlâ kullanılıyor.
gibi zihinsel model oluşturuyor.
Graphify'ın çözmeye çalıştığı şey aslında:
AI agent'a kalıcı bir teknik hafıza vermek.
Graphify Labs'ın kendisini “knowledge-graph memory layer for AI coding assistants” olarak tanımlamasının sebebi de bu.
Agent Teams ile birlikte neden daha anlamlı?
Tek agent olduğunda aynı agent zaman içerisinde sistemi keşfedebilir.
Ama dört agent çalıştırdığınızda:
4 farklı context window
4 farklı araştırma
4 farklı sistem anlayışı
oluşuyor.
Ortak graph bunu:
4 Agent
   ↓
1 ortak sistem modeli
haline getirebilir.
Bence multi-agent coding sistemlerinin ileride ihtiyaç duyacağı temel katmanlardan biri tam olarak bu olacak:
Shared Memory.
Agent'ların birbirleriyle mesajlaşması yeterli değil.
Aynı dünyaya baktıklarından da emin olmak gerekiyor.
Sonuç
Graphify yeni bir yapay zekâ modeli değil.
Kod yazmıyor.
Claude'un yerine geçmiyor.
Claude Code Agent Teams'in alternatifi de değil.
Graphify'ın yaptığı daha temel bir şey:
AI'a projenizin haritasını vermek.
Normal agent:
Dosyaları bulur
↓
Okur
↓
Bağlantıları tahmin eder
Graphify kullanan agent:
Graph'a bakar
↓
Bağlantıyı bulur
↓
İlgili kaynak dosyayı açar
↓
Doğrular
Bu küçük bir fark gibi görünebilir.
Ama projeler büyüdükçe AI coding'in en büyük problemlerinden biri kod üretmek değil:
context yönetmek
olacak.
Ve Graphify'ın ilginç olduğu yer tam olarak burası.
Graphify bugün kusursuz değil.
Graph eskiyebilir.
Inference yanlış olabilir.
Dinamik runtime ilişkilerini kaçırabilir.
Token tasarrufu her projede 70× olmayabilir.
Küçük projelerde gereksiz bile olabilir.
Ama arkasındaki fikir bana göre oldukça güçlü:
Bir yapay zekâya milyonlarca satır kodu tekrar tekrar okutmak yerine, önce yazılımın haritasını öğretmek.
Ve Claude Code gibi araçlar tek agent'tan çıkıp onlarca paralel agent'ın aynı proje üzerinde çalıştığı sistemlere doğru ilerledikçe bu tarz ortak knowledge katmanlarının önemi muhtemelen daha da artacak.
Bugün:
AI + Codekullanıyoruz.
Yakın gelecekte ise daha çok şuna benzeyen sistemler görebiliriz:
AI Agents
    +
Knowledge Graph
    +
Persistent Memory
    +
MCP
    +
Tools
    =
Software Development System
Belki Graphify birkaç yıl sonra kullandığımız araç olmayacak.
Ama AI'ın kod tabanını düz metin dosyaları olarak değil, birbirine bağlı bir sistem olarak görmesi gerektiği fikri bence kolay kolay kaybolmayacak.
Araştırma tarihi: 11 Ekim 2026.
Yorumlar 00
Yorumlar onaylandıktan sonra yayınlanır. E-posta adresin hiçbir yerde gösterilmez.