JEPA Nedir? 109 Milyon Parametreli Model 72 Milyarlık Qwen'i Nasıl Geçti?
Yapay zekâ dünyasında uzun süredir benzer bir yarış yaşanıyor: Daha fazla parametre, daha büyük veri kümeleri ve daha güçlü GPU'lar. Milyarlarca dolarlık yatırımların önemli bir bölümü, daha büyük dil modelleri geliştirmek için harcanıyor.
Peki ya yapay zekâyı geliştirmenin yolu yalnızca modelin boyutunu büyütmek değilse?
29 Ekim 2026'da Randall Balestriero ve Yann LeCun tarafından yayımlanan "Proving and Improving the Platonic Representation Hypothesis with JEPAs" başlıklı araştırma, bu soruyu yeniden gündeme taşıdı.
Araştırmacılar, yalnızca 109 milyon parametreye sahip bir metin JEPA modelinin, belirli görsel-metin temsil uyumu testlerinde 72 milyar parametreli Qwen2.5 modelinden daha yüksek sonuçlar elde ettiğini açıkladı.
Üstelik model, testte kullanılan görüntülerin pikselleri üzerinden eğitilmemişti.
Ancak burada dikkat edilmesi gereken önemli bir ayrıntı var: JEPA, Qwen'den daha iyi sohbet etmiyor, daha iyi kod yazmıyor veya bütün akademik soruları daha doğru cevaplamıyor.
Araştırmanın gösterdiği şey, çok daha farklı ve potansiyel olarak önemli: Yapay zekâya bilgiyi nasıl öğrettiğimiz, bazı görevlerde modelin büyüklüğünden daha etkili olabilir.
1. JEPA Nedir?
JEPA, Joint-Embedding Predictive Architecture ifadesinin kısaltmasıdır. Türkçeye yaklaşık olarak Ortak Gömme Tahmin Mimarisi şeklinde çevrilebilir.
Bu mimarinin temelinde, yapay zekânın verileri doğrudan yeniden üretmek yerine onların sayısal temsillerini öğrenmesi bulunur.
Geleneksel üretici modeller çoğunlukla metin, görüntü veya başka türde çıktılar oluşturmak üzere eğitilir. JEPA ise belirli bir gözlemden hareketle başka bir gözlemin temsilini tahmin etmeyi öğrenir.
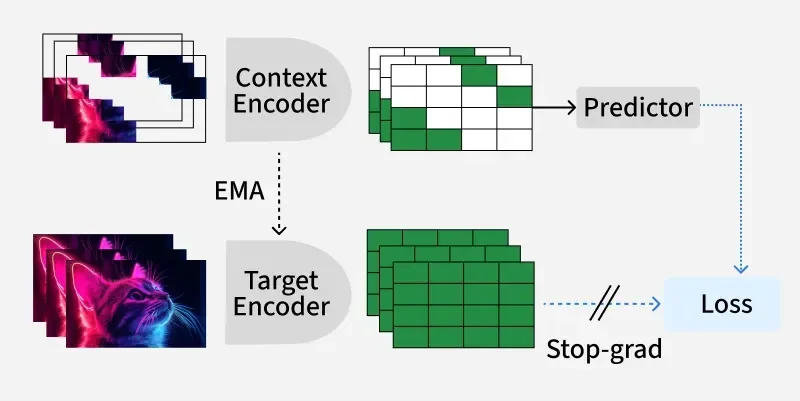
Örneğin bir yapay zekâya şu görüntüyü verdiğimizi düşünelim:
Bir kedi masanın üzerinde oturuyor. Görüntünün ortasındaki bölge kapatılmış.
Görüntü üretmeye yönelik bir modelden eksik pikselleri tamamlamasını isteyebiliriz.
I-JEPA'da ise sistem, gizlenen bölgenin her pikselini oluşturmak zorunda değildir. Onun yerine, o bölgenin bir encoder tarafından hesaplanan sayısal temsilini tahmin eder.
Bu temsil yüzlerce veya binlerce sayıdan oluşabilir.
Örneğin:
Görüntü: Masanın üzerinde oturan kedi

Context Encoder:
[0.18, 0.72, -0.41, 0.93, ...]

Predictor:
[0.21, 0.68, -0.39, 0.89, ...]

Target Encoder:
[0.20, 0.70, -0.40, 0.91, ...]

Sonuç:
Tahmin ile hedef arasındaki fark hesaplanır.
Yukarıdaki sayılar yöntemi açıklamak için oluşturulmuş örnek değerlerdir.
Modelin amacı, kendi tahminini hedef temsile giderek yaklaştırmaktır.
Bu yaklaşım, öz denetimli öğrenme (self-supervised learning) ailesinin bir parçasıdır. İnsanların her görüntüyü veya metni ayrı ayrı etiketlemesi gerekmeden eğitim hedefleri oluşturulabilir.
2. JEPA Nasıl Eğitiliyor?
JEPA'nın temel eğitim sürecini üç ana bileşenle açıklayabiliriz.
Context Encoder
İlk bileşen, modelin görebildiği bilgileri sayısal bir temsile dönüştürür.
Örneğin bir görüntünün yalnızca belirli bölgeleri veya bir metnin belirli bölümleri encoder'a verilebilir.
Predictor
İkinci bileşen, context encoder tarafından oluşturulan temsili kullanarak hedef bilginin nasıl bir temsil taşıması gerektiğini tahmin eder.
Burada modelden doğrudan bir görsel veya cümle üretmesi istenmez.
Target Encoder ve eğitim kaybı
Üçüncü bileşen, hedef veriye ait temsili oluşturur.
Modelin tahminiyle hedef temsil arasındaki fark hesaplanır ve öğrenen ağın parametreleri bu hatayı azaltacak şekilde güncellenir.
Basitleştirilmiş bir eğitim kaybı şu şekilde gösterilebilir:
Loss = || predicted_embedding - target_embedding ||²Bu, iki temsil arasındaki karesel uzaklığın ölçülebileceği anlamına gelir.
Ancak gerçek sistemlerde yalnızca bu hesabı yapmak yeterli değildir. Modelin bütün girdiler için aynı temsili üretmesini önleyen mekanizmalar da gerekir.
Örneğin 2023'te tanıtılan I-JEPA, yavaş güncellenen bir hedef encoder kullanırken, LeJEPA gibi sonraki yaklaşımlar farklı düzenlileştirme tekniklerinden yararlanır.
JEPA tek bir sabit sinir ağı değil, farklı model türlerine uygulanabilen bir öğrenme yaklaşımıdır.
3. Akademik Makaleleri JEPA'ya Nasıl Öğretebiliriz?
JEPA yalnızca fotoğraflar veya videolar üzerinden çalışmak zorunda değildir.
Metinler de bu yaklaşımla kullanılabilir.
Örneğin Newton'un ikinci yasasını açıklayan iki akademik metin düşünelim.
Birinci metin:
Bir nesnenin ivmesi, üzerine uygulanan net kuvvetle doğru, kütlesiyle ters orantılıdır.
İkinci metin:
Aynı kuvvet altında kütlesi daha büyük bir cismin ivmesi daha düşük olacaktır.
Bu iki açıklama birbirinden farklı kelimeler kullanıyor. Ancak ikisi de aynı fiziksel ilişkiye işaret ediyor.
JEPA tabanlı bir metin modelini bu tür açıklamaları birbirine yaklaştıracak şekilde eğitebiliriz.
METİN A ──► Encoder A ──► Embedding A
                                  │
                            Karşılaştırma
                                  │
METİN B ──► Encoder B ──► Embedding B
Buradaki temel fikir, iki metnin aynı bilimsel olguyu farklı biçimlerde anlattığını öğrenmektir.
Fakat önemli bir ayrım var.
Bir modelin iki bilimsel açıklamayı benzer olarak temsil etmesi, fizik denklemlerini doğru uygulayabildiğini veya yeni bir bilimsel keşif yapabildiğini kanıtlamaz.
Bu yetenekler ayrıca değerlendirilmelidir.
4. 109M JEPA, 72B Qwen'i Gerçekten Geçti mi?
Evet, ancak belirli bir görevde.
2026 yılında yayımlanan araştırmada, 109 milyon parametreli bir metin JEPA modeli ile Qwen2.5-72B ve Llama-3-70B gibi büyük dil modelleri karşılaştırıldı.
Araştırmacılar, metin modellerinin öğrendiği sayısal temsillerin görsel modellerin temsilleriyle ne kadar uyumlu olduğunu ölçtü.
WIT-1024 üzerinde, DINOv2 ViT-B görsel encoder ile yapılan karşılaştırmanın bildirilen sonuçları şöyleydi:
| Model | Temsil uyumu puanı |
|---|---|
| JEPA 109M | 0.184 |
| Qwen2.5 72B | 0.154 |
| Llama-3 70B | 0.151 |
| CLIP Text Encoder | 0.124 |
Daha yüksek puan, bu ölçümde daha güçlü temsil uyumu anlamına geliyor.
Sonuç dikkat çekici.
Çünkü Qwen2.5-72B yaklaşık 72 milyar, JEPA ise yalnızca 109 milyon parametreye sahip. Aralarında yaklaşık 660 kat parametre farkı bulunuyor.
Ancak bu tabloyu yanlış yorumlamamak gerekiyor.
Araştırmacılar burada matematik çözme, kodlama, sohbet etme veya genel bilgi sorularını yanıtlama performansını ölçmedi.
Ölçülen şey, birbirinden farklı veri türlerinden öğrenilen temsillerin ne kadar örtüştüğüydü.
Dolayısıyla "109M JEPA, 72B Qwen'den daha zeki" demek bilimsel olarak doğru bir sonuç olmaz.
5. Asıl Yenilik: Good Views ve Bad Views
Araştırmanın en ilginç bölümlerinden biri, eğitimde kullanılan veri çiftlerinin nasıl oluşturulduğuyla ilgili.
Araştırmacılar iki kavram üzerinde duruyor:
- Good Views: Aynı olguyu veya sahneyi temsil eden farklı gözlemler.
- Bad Views: Tek bir gözlemin kırpılmış, maskelenmiş veya parçalanmış sürümleri.
Bir örnek üzerinden inceleyelim.
Bir görüntüde mağazanın kasasında bekleyen bir müşteri olsun.
Aynı sahne için iki farklı açıklama oluşturabiliriz:
Gözlem A:
Bir müşteri market kasasında ödeme bekliyor.

Gözlem B:
Alışverişini tamamlayan bir kişi
kasiyerin önünde sırada duruyor.
İki açıklama farklı kelimeler kullanmasına rağmen aynı sahneyi tanımlıyor.
2026 araştırmasının good views yaklaşımı, bu tür bağımsız gözlemler arasında ortak bir temsil öğrenmenin avantajlarını inceliyor.
Buna karşılık tek bir cümlenin iki parçasını eşleştirmek, aynı çeşitlilikte gözlem sağlamayabilir.
Burada önemli bir teknik ayrıntı bulunuyor: 2023'teki I-JEPA da görüntülerin maskelenmiş bölümlerini kullanıyordu. 2026 çalışmasındaki good views/bad views ayrımı ise özellikle farklı veri türlerinin ortak temsillere ulaşması açısından inceleniyor. Bu nedenle maskelenmiş veriyle yapılan bütün öğrenme yöntemlerinin işe yaramaz olduğu sonucu çıkarılamaz.
Araştırmacıların temel savı şu:
Öğrenme sırasında hangi gözlemleri birbirinin karşılığı olarak seçtiğimiz, modelin nasıl bir bilgi temsili geliştireceğini ciddi şekilde etkileyebilir.
6. 42 Kat Daha Verimli Öğrenme İddiası
2026 araştırmasında bir diğer dikkat çekici sonuç da eğitim örnekleriyle ilgili.
Aynı model boyutu ve veri kaynağı üzerinde gerçekleştirilen karşılaştırmada:
- Good-view JEPA, yaklaşık 21,6 milyon eğitim örneğiyle belirli bir temsil uyumu seviyesine ulaştı.
- Sonraki token tahminine dayalı yaklaşım, benzer seviyeye ulaşmak için yaklaşık 900 milyon eğitim örneğine ihtiyaç duydu.
Bu, söz konusu deneyde yaklaşık 42 kat daha az örnekle benzer bir sonuca ulaşıldığı anlamına geliyor.
Ancak bunu "JEPA her durumda 42 kat daha az GPU kullanır" şeklinde yorumlamamak gerekiyor.
Bir modelin gerçek eğitim maliyeti yalnızca örnek sayısına bağlı değildir. Encoder mimarileri, batch büyüklüğü, veri hazırlama süreci ve eğitim sırasında yapılan hesaplamalar da önemlidir.
Üstelik 109M modelin büyük ölçekli eğitiminde, 940 milyon web görüntüsüyle ilişkili metinler ve önceden eğitilmiş başka bir görsel modelin oluşturduğu açıklamalar kullanıldı.
Yani küçük modelin arkasında yine büyük bir veri işleme süreci bulunuyor.
7. JEPA ile ChatGPT Arasındaki Fark Nedir?
GPT, Qwen ve benzeri otoregresif dil modelleri, eğitim sırasında önceki tokenlardan hareketle sonraki tokenı tahmin etmeyi öğrenir.
Örneğin:
Girdi:
Türkiye'nin başkenti ...

Hedef:
Ankara
Elbette gerçek dil modeli eğitimi bu kadar basit değildir. Milyarlarca farklı metin üzerinden öğrenilen örüntüler, modellerin çeviri, kodlama, açıklama ve çeşitli akıl yürütme görevlerini gerçekleştirmesine yardımcı olur.
JEPA ise doğrudan sonraki kelimeyi üretmeye odaklanmak zorunda değildir.
Onun eğitim hedefi, farklı gözlemlerin sayısal temsilleri arasındaki ilişkileri öğrenmek olabilir.
| Özellik | Otoregresif dil modeli | JEPA yaklaşımı |
|---|---|---|
| Temel eğitim hedefi | Sonraki token tahmini | Hedef temsil tahmini |
| Doğrudan metin üretimi | Evet | Ek bileşen gerekebilir |
| Öğrenilen bilgi | Dilsel ve kavramsal örüntüler | Göreve bağlı soyut temsiller |
| Görsel öğrenme | Multimodal modellerde mümkün | I-JEPA ve V-JEPA ile mümkün |
| Sohbet asistanı olarak kullanım | Doğrudan uygun | Tek başına yeterli değil |
İki yaklaşım birbirini dışlamak zorunda değil.
Gelecekte dil modellerinin bilgi üretme yetenekleriyle JEPA tabanlı temsil ve dünya modellerinin birleştirilmesi, araştırmaya değer bir yön olabilir.
8. JEPA Modelini Kendi Bilgisayarımızda Çalıştırabilir miyiz?
Parametre sayısı açısından küçük JEPA modelleri tüketici ekran kartlarında çalıştırılabilecek boyutlarda olabilir.
Örneğin 109 milyon parametreli bir modelin yalnızca ağırlıkları yaklaşık olarak:
| Sayısal hassasiyet | Tahmini ağırlık boyutu |
|---|---|
| FP32 | 436 MB |
| FP16 / BF16 | 218 MB |
| INT8 | 109 MB |
Bu değerler yalnızca model ağırlıklarının teorik boyutlarıdır. Çalışma sırasında ara hesaplamalar, ek encoder'lar ve diğer bileşenler daha fazla bellek kullanır.
Dolayısıyla 12 GB VRAM'e sahip bir ekran kartı, 109M büyüklüğünde tek bir modeli çalıştırmak için genellikle yeterlidir.
Buna karşılık araştırmadaki 940 milyon görüntüyle ilişkili metinler üzerinden yapılan eğitimi aynı donanımda kolayca tekrarlamak mümkün olmayabilir.
Araştırmanın kaynak kodları GitHub üzerinde yayımlanmıştır. Daha küçük veri kümeleriyle eğitim deneyleri gerçekleştirmek mümkündür.
Ancak araştırmanın kaynak kodunun yayımlanmış olması, kullanılan bütün eğitilmiş model ağırlıklarının aynı şekilde doğrudan indirilebildiği anlamına gelmez.
9. JEPA Yapay Zekânın Geleceğini Değiştirebilir mi?
Bu sorunun kesin bir cevabı henüz yok.
JEPA araştırmaları, mevcut yapay zekâ yöntemlerinin önemli bir sınırına odaklanıyor: Öğrenilen bilginin yalnızca metin üretiminde değil, dünyayı temsil etme, farklı gözlemleri ilişkilendirme ve bazı sistemlerde gelecekteki durumları öngörme süreçlerinde de kullanılabilmesi.
2025 yılında tanıtılan V-JEPA 2, video verileriyle öğrenilen temsillerin hareket anlama ve robotik planlama gibi görevlerde kullanılabileceğini gösterdi.
2026 yılındaki 109M araştırması ise başka bir noktaya dikkat çekti: Farklı veri türleri arasında ortak temsil öğrenmek için modelin mutlaka onlarca milyar parametreye sahip olması gerekmeyebilir.
Yine de bu çalışmaların her biri belirli görevler ve değerlendirme yöntemleri üzerinde gerçekleştiriliyor.
Bir temsil modelinin küçük olması, her görevi küçük bir modelle çözebileceğimiz anlamına gelmiyor. Ayrıca akademik makalelerden öğrenilen bilgilerin bilimsel problemlerde doğru uygulanması, hâlâ ayrı bir araştırma konusu.
Sonuç
Yapay zekâ alanında uzun süredir devam eden yaklaşım, daha büyük modellerin daha güçlü yetenekler ortaya çıkarabileceği düşüncesi etrafında şekilleniyor.
JEPA araştırmaları bu yaklaşımı tamamen reddetmiyor. Ancak başka bir soruyu daha güçlü biçimde gündeme getiriyor:
Yapay zekâya daha fazla bilgi vermek yerine, aynı bilgiyi daha doğru ilişkiler kurarak öğretirsek ne olur?
109 milyon parametreli bir modelin, belirli bir temsil uyumu testinde 72 milyar parametreli Qwen'i geçmesi, bu sorunun neden önemli olduğunu gösteriyor.
Bu sonuç henüz yeni bir genel yapay zekâ çağının başladığını kanıtlamıyor.
Ama şunu hatırlatıyor: Bir yapay zekânın başarısını yalnızca parametre sayısı değil, neyi ve nasıl öğrendiği de belirliyor.
Benim notum:
Bana kalırsa illaki bir gün yeni bir tokenizer mantığı veya denklemi çıkacak.
Çıkması lazım çünkü günümüzün teknolojileri el vermiyor şuan gelişmesine engel oluyor.
Yorumlar 00
Yorumlar onaylandıktan sonra yayınlanır. E-posta adresin hiçbir yerde gösterilmez.