Gördüğünüz gibi yapay zeka düzenli değil orantısız bir şekilde hızla gelişiyor, fark ettiniz mi bilmem ama son 1 ayda gpt-6 astra ve claude opus 5.5 gibi yeni modelleri saymamamıza rağmen hala çok fazla haber başlıkları oluyor.
Bunlardan ilki JEV sonra GRAPHIFY şimdi de REA çıktı , peki nedir bu REA ?
Reverse Engineer Anything adından da anlaşılacağı üzerine herhangi birşeyi tersine mühendislik yapmanızı sağlıyor.
Yani bir oyunu tersine mühendislik ile açıp onu modlayabilir veya bir uygulamayı açıp onun payload şifrelemesi için üretilecek şifre algoritmasını görebilirsin...
Haliyle yıllardır bir türlü public olmayan uygulamarın private apileri artık githubda görmeye başlıcağımızı düşünüyorum.
REA Nedir? Claude Code ve AI Agent’larla Reverse Engineering Dönemi
Bir uygulamada hoşunuza giden bir özellik gördünüz.
Kaynak kodu yok.
Dokümantasyonu yok.
Elinizde yalnızca çalışan uygulama, APK, .exe, Electron paketi veya web sitesi var.
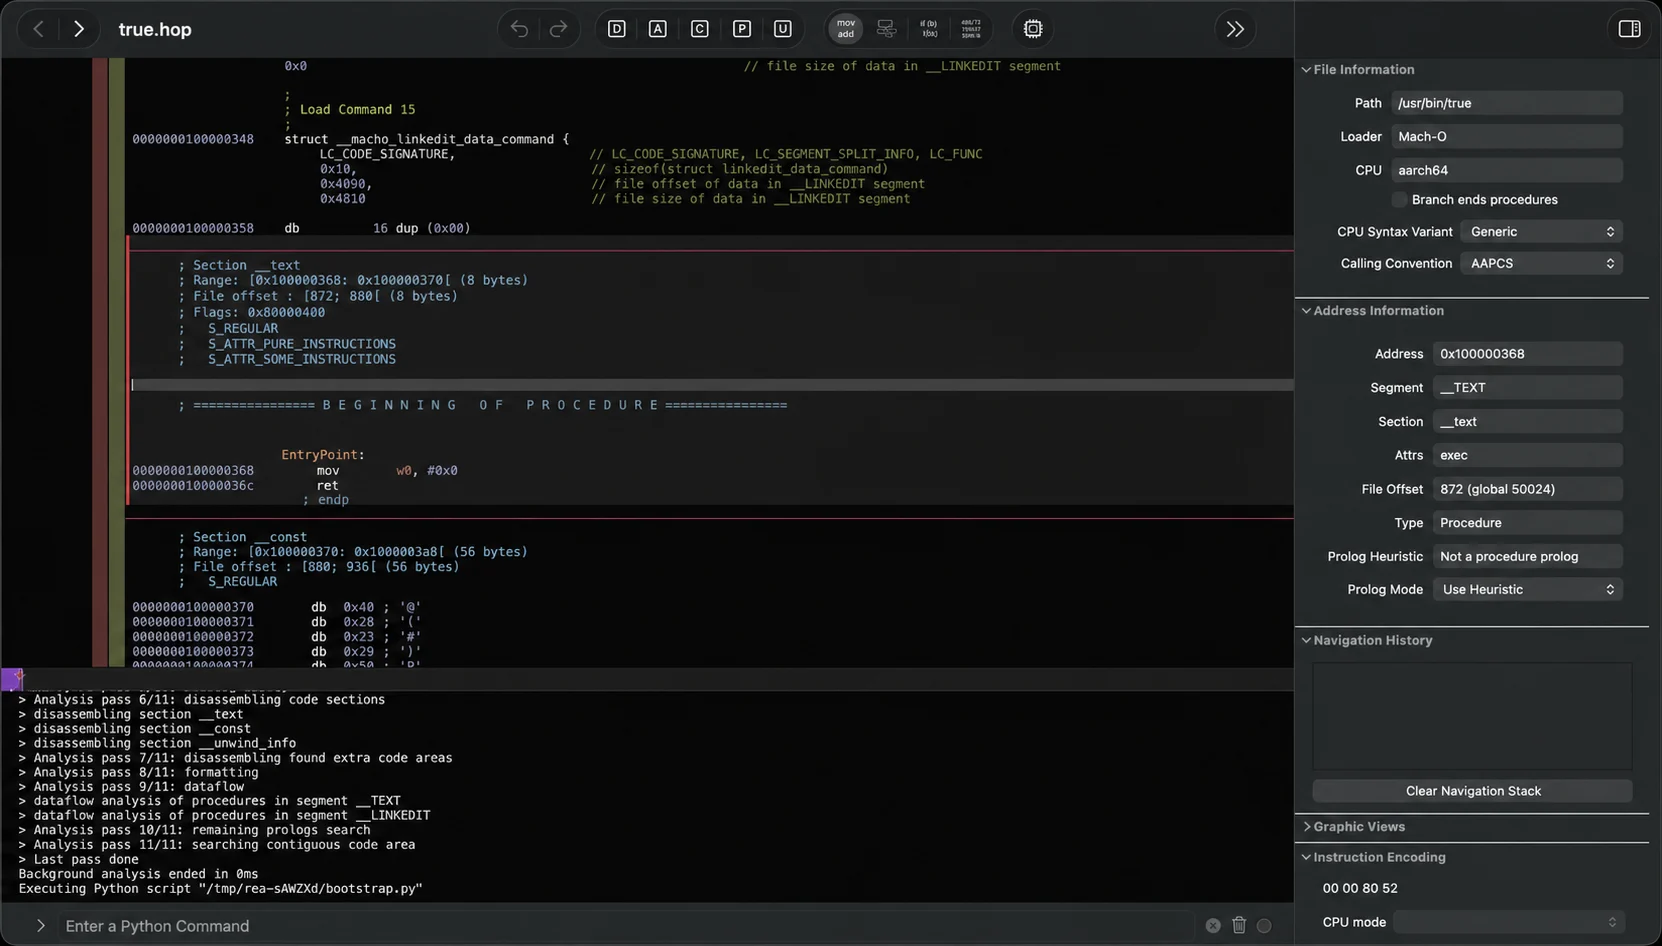
Eskiden burada iş büyük ölçüde reverse engineering bilen birinin Ghidra, IDA, Hopper, JADX gibi araçların başına oturmasıyla başlıyordu.
2026'da ortaya çıkan REA — Reverse Engineer Anything ise bu araçların başına doğrudan bir AI coding agent oturtmaya çalışıyor.
Claude Code'a:
“Bu uygulamadaki arama sistemi nasıl çalışıyor?”
diye soruyorsunuz.
Claude tek başına tahmin yürütmek yerine REA üzerinden uygulamayı inceleyebiliyor, ilgili fonksiyonları takip edebiliyor, bulduğu kanıtları toplayabiliyor ve daha sonra size ne olduğunu açıklayabiliyor.
REA'nın olayı tam olarak bu.
AI'a reverse engineering araçları vermek.
14 Ekim 2026 itibarıyla projenin resmî GitHub deposu yaklaşık 238 bin star seviyesine ulaşmış durumda. Proje MIT lisansıyla açık kaynak olarak geliştiriliyor.
REA Aslında Nedir?
REA'nın açılımı:
Reverse Engineer Anything
Fakat ismindeki “Anything” biraz yanlış anlaşılabilir.
REA tek başına sihirli bir decompiler değil.
Bir .exe dosyasını REA'ya verip:
“Bunun orijinal kaynak kodunu çıkar.”
dediğinizde kaynak kodun birebir geri gelmesini sağlayan bir sistemden bahsetmiyoruz.
REA'yı daha çok bir köprü olarak düşünmek gerekiyor.
Bir tarafta:
Claude Code
Codex
Cursor
Gemini CLI
VS Code Agent
vb.
bulunuyor.
Diğer tarafta ise:
Ghidra
Hopper
IDA
JADX
ADB
Browser
Network Capture araçları
vb.
bulunuyor.
Ortada da REA var.
AI Coding Agent
       ↓
      MCP
       ↓
      REA
       ↓
Reverse Engineering Araçları
       ↓
    Evidence
       ↓
AI'ın açıklaması
REA, Model Context Protocol yani MCP üzerinden coding agent'a reverse engineering araçlarını kullanabilme yeteneği kazandırıyor.
Neden Bu Kadar İlgi Çekti?
Çünkü coding agent'ların bugüne kadarki en büyük problemlerinden biri şuydu:
Görebildikleri kod üzerinde çok iyiler.
Claude Code'a bir GitHub projesi verin.
Dosyaları açabilir.
Fonksiyonları takip edebilir.
Bug bulabilir.
Yeni özellik yazabilir.
Fakat kaynak kodu olmayan bir uygulamada durum tamamen değişiyor.
Claude:
.exe
.dll
.apk
.asar
binary
gibi şeyleri insanların reverse engineering yaptığı şekilde kendi başına inceleyemiyor.
REA tam bu noktada devreye giriyor.
AI'a:
“Tahmin etme. Gidip programa bak.”
diyor.
REA Nasıl Çalışıyor?
REA'nın çalışma modeli aslında oldukça mantıklı.
Diyelim bir uygulamadaki belirli bir özelliği merak ediyoruz.
Örneğin:
“Bu uygulamadaki arama sistemi nasıl çalışıyor?”
Agent önce REA'ya soru gönderiyor.
REA hedefin türüne göre uygun analiz aracını kullanıyor.
Ardından:
- fonksiyonlar,
- string'ler,
- çağrılar,
- referanslar,
- modüller,
- import'lar,
- IPC bağlantıları,
- network davranışları
gibi kanıtları çıkarıyor.
Sonra agent bu sonuçlar üzerinden yeni sorular soruyor.
Kullanıcı sorusu
      ↓
Agent
      ↓
REA ile inceleme
      ↓
İlk bulgular
      ↓
Yeni soru
      ↓
Daha derin inceleme
      ↓
Evidence
      ↓
Sonuç
Yani olay tek seferlik:
“Dosyayı decompile et ve bana ver.”
sistemi değil.
Daha çok bir araştırma döngüsü.
REA'nın resmî açıklamasında da agent'ın hedefi inceleyip ilgili kodu takip ettiği, REA'nın bulguları kanıtlarıyla döndürdüğü ve agent'ın bu sonuçlarla yeni sorular sorabildiği belirtiliyor.
Evidence Sistemi Bence REA'nın En Önemli Tarafı
LLM kullanan herkesin bildiği bir problem var:
Model bazen bilmese bile biliyormuş gibi konuşabiliyor.
Reverse engineering gibi bir alanda bu çok daha tehlikeli.
Bir AI'ın:
“Bu fonksiyon login token üretiyor.”
demesi pek bir şey ifade etmiyor.
Asıl soru şu:
Nereden biliyorsun?
REA bu yüzden bulguları “evidence” ile birlikte vermeye odaklanıyor.
Örneğin sonuç:
Fonksiyon A
↓
Fonksiyon B'yi çağırıyor
↓
Şu string'e referans veriyor
↓
Şu assembly bloğunda bu işlem yapılıyor
şeklinde takip edilebilir.
Dolayısıyla agent sadece:
“Bence böyle.”
demiyor.
Bulduğu sonucun hangi binary bölümüne, fonksiyona veya uygulama davranışına dayandığını gösterebiliyor.
Bu yaklaşım REA'nın basit bir “AI decompiler” olmaktan ayrıldığı noktalardan biri.
REA Neleri İnceleyebiliyor?
Desteklenen hedef listesi beklediğimden oldukça geniş.
Native binary dosyaları
Windows .exe, kütüphaneler veya native binary'ler için:
- pseudocode,
- assembly,
- strings,
- symbols,
- function calls,
- references
çıkarılabiliyor.
Burada REA arka tarafta Ghidra, Hopper veya IDA gibi gerçek reverse engineering araçlarından yararlanıyor.
JavaScript ve Electron uygulamaları
Electron uygulamalarında işler daha da ilginç.
REA:
- modülleri,
- import ilişkilerini,
- source map'leri,
- route'ları,
- IPC bağlantılarını,
- native addon ilişkilerini
haritalayabiliyor.
Üstelik statik JavaScript analizi için Ghidra gibi bir native decompiler gerekmiyor.
Discord, Notion, VS Code benzeri Electron mimarilerini düşününce bunun neden ilginç olduğu daha net anlaşılıyor.
Android APK Analizi
REA Android tarafını da destekliyor.
APK üzerinde:
Manifest
Classes
Methods
References
gibi bölümler incelenebiliyor.
Burada arka planda JADX kullanılıyor.
Android cihaz bağlandığında ADB üzerinden:
- package,
- process,
- logs,
- screenshot,
- file transfer
gibi farklı inceleme yetenekleri de kullanılabiliyor.
Bu yüzden REA sadece masaüstü programlarına yönelik bir araç değil.
Web Sitelerini de İnceleyebiliyor
REA'nın bana göre en ilginç bölümlerinden biri browser tarafı.
Chrome tabanlı bir browser üzerinden:
- sayfa yapısını,
- çalışan script'leri,
- network davranışlarını,
- ekran görüntülerini
inceleyebiliyor.
Örneğin agent'a:
“Bu sitede Export butonuna bastığımda ne oluyor?”
dediğinizi düşünün.
Agent teorik cevap vermek yerine browser davranışını inceleyip hangi request'in oluştuğunu, hangi script'in devreye girdiğini ve işlemin hangi aşamalardan geçtiğini araştırabilir.
Network Capture Analizi
REA ayrıca kayıt edilmiş:
HAR
SAZ
PCAP
gibi network çıktıları üzerinde de çalışabiliyor.
HTTP request ve response'ları, endpoint'leri, DNS/TLS bilgilerini veya tekrar eden network davranışlarını incelemek mümkün.
Bu da REA'yı yalnızca “decompiler kullanan AI” olmaktan çıkarıp daha genel bir software investigation framework haline getiriyor.
.NET, Go, Rust, WASM ve Firmware
Destek burada da bitmiyor.
REA'nın güncel araç listesinde:
.NET assemblies- Go binaries
- Rust binaries
- WebAssembly
- SQLite
- firmware
- EVM bytecode
- packet captures
gibi oldukça farklı hedefler bulunuyor.
Her hedef aynı araçla analiz edilmiyor.
REA burada bir router gibi davranıyor.
APK
 ↓
JADX

Native EXE
 ↓
Ghidra / Hopper / IDA

Website
 ↓
Browser

Electron
 ↓
JavaScript analysis

Android cihaz
 ↓
ADB
Claude Code ile Kullanıldığında Ne Değişiyor?
Bence REA'yı anlamanın en kolay yolu Claude Code üzerinden düşünmek.
Normal Claude Code:
Kaynak kod
    ↓
Claude
    ↓
Analiz
REA sonrası:
Kaynak kodu olmayan uygulama
          ↓
         REA
          ↓
Ghidra / JADX / Browser / ...
          ↓
        Evidence
          ↓
      Claude Code
Claude artık sadece kendisine verilen kaynak kodla sınırlı değil.
Uygulamayı analiz eden diğer araçlardan bilgi çekebiliyor.
Bu aslında coding agent'ların erişebildiği alanı ciddi biçimde genişletiyor.
REA Bir Uygulamayı Klonlayabilir mi?
Burada internette biraz abartı var.
REA'nın kendi sitesinde bile uygulamadaki bir özelliği anlayıp benzerini kendi projenizde oluşturma örnekleri gösteriliyor.
Ama:
“REA'ya Photoshop.exe veriyorsun, 15 dakika sonra Photoshop kaynak kodu çıkıyor.”
gibi bir sistem değil.
Reverse engineering sırasında kaybolan bilgiler var.
Örneğin:
- orijinal değişken isimleri,
- yorumlar,
- kaynak proje yapısının bazı parçaları,
- build pipeline,
- backend servisleri,
- server-side business logic
binary içerisinde bulunmayabilir.
REA'nın yaptığı daha çok:
Decompile
↓
Understand
↓
Evidence
↓
Reimplement
şeklinde.
Yani orijinal source code'u geri getirmek yerine agent'ın davranışı anlamasına ve yeniden uygulamasına yardımcı oluyor.
Gerçek Bir Örnek: DX-Ball
REA'nın resmî showcase'lerinden biri eski DX-Ball oyunu üzerinde.
Araştırmanın amacı oyunun tamamını bir tuşla kopyalamak değil.
Oldukça spesifik bir problemi çözmek:
Sesin stereo pan hesaplaması nasıl yapılıyor?
REA üzerinden ilgili sound fonksiyonu takip ediliyor.
Position-to-pan helper bulunuyor.
Assembly inceleniyor.
Eksik pseudocode tamamlanıyor.
Daha sonra aynı davranışı üreten C implementasyonu hazırlanıyor.
REA ekibinin yayınladığı sonuca göre yeniden oluşturulan hesaplama 3.205 orijinal x86 test durumunu geçiyor ve ilgili derlenmiş fonksiyonun 63 byte'ının tamamını yeniden üretiyor.
Bence bu örnek REA'nın ne olduğunu çok güzel gösteriyor.
Amaç:
“Oyunu bana kopyala.”
değil.
Amaç:
“Bu davranış tam olarak nasıl çalışıyor?”
Notion Üzerinde de Kullanılmış
Bir başka resmî showcase ise Notion.
Burada Electron uygulamasındaki clipboard sistemi araştırılıyor.
Akış:
Renderer
↓
Preload
↓
IPC
↓
Main Process
↓
Clipboard
şeklinde takip ediliyor.
Yani kullanıcıya görünen:
“Copy”
butonunun arkasındaki Electron iletişim zinciri reverse engineering ile ortaya çıkarılıyor.
Bu da REA'nın yalnızca eski oyun veya C binary'lerinde çalışan bir sistem olmadığını gösteriyor.
REA'nın En Büyük Değiştirdiği Şey Ne?
Reverse engineering araçları zaten vardı.
Ghidra vardı.
IDA vardı.
Hopper vardı.
JADX vardı.
Binwalk vardı.
Browser DevTools vardı.
REA'nın yeniliği bunların hiçbirini icat etmek değil.
Asıl değişiklik:
Bu araçları bir AI agent'ın kullanabilmesi.
Eskiden:
İnsan
↓
Ghidra
↓
Assembly
↓
Pseudocode
↓
Yeni hipotez
↓
Başka fonksiyon
↓
Tekrar analiz
Şimdi:
İnsan
↓
"Bu özellik nasıl çalışıyor?"
↓
AI Agent
↓
REA
↓
Ghidra / JADX / Browser
↓
Evidence
↓
AI Agent
↓
Açıklama / Kod
İnsan hâlâ neyi araştıracağını belirliyor.
Ama araştırmanın mekanik kısmının önemli bir bölümü agent'a devredilebiliyor.
MCP Burada Neden Önemli?
REA'nın arkasındaki kritik teknolojilerden biri Model Context Protocol.
MCP sayesinde Claude Code veya başka bir desteklenen agent REA'nın fonksiyonlarını araç olarak görebiliyor.
Örneğin agent:
binary aç
↓
fonksiyonu bul
↓
references getir
↓
pseudocode getir
↓
başka fonksiyonu takip et
gibi işlemleri konuşmanın ortasında gerçekleştirebiliyor.
REA'nın setup sistemi Claude Code, Codex, Cursor, Gemini CLI ve birçok farklı MCP istemcisini destekliyor.
Bu yüzden REA belirli bir AI modeline bağlı değil.
Asıl şart agent'ın MCP araçlarını kullanabilmesi.
REA Lokal mi Çalışıyor?
Bu konuda önemli bir ayrım var.
REA hedef dosyayı analiz etmek için lokal araçları kullanıyor.
Yani REA'nın kendisi uygulamanızı otomatik olarak bir bulut reverse-engineering servisine upload etmiyor.
Fakat:
Agent'a dönen analiz sonuçları kullandığınız AI sağlayıcısına gönderilebilir.
Örneğin Claude Code kullanıyorsanız modelin görebildiği REA çıktıları Anthropic tarafındaki ilgili veri politikalarına tabi.
Dolayısıyla:
Uygulamanın tamamı
→ lokal analiz

Analiz sonucu / Evidence
→ AI agent tarafından işlenebilir
ayrımını yapmak gerekiyor.
REA'nın “local” olması otomatik olarak hiçbir bilginin model sağlayıcısına gitmediği anlamına gelmiyor.
Kurulum Tarafı
Temel kurulum oldukça kısa:
npx rea-agents setupSetup sırasında hangi coding agent'a bağlanacağını seçiyorsunuz.
REA gerekli MCP kaydını ve agent'ın REA'yı nasıl kullanacağını anlatan workflow talimatlarını ekliyor.
Ardından agent yeniden başlatılıyor.
Native binary analizi yapmak istiyorsanız ayrıca:
- Ghidra,
- Hopper,
- IDA
gibi bir analiz motoruna ihtiyaç duyulabiliyor.
JavaScript/Electron statik analizi gibi bazı işlemler ise bunlara ihtiyaç duymuyor.
REA Reverse Engineering'i Kolaylaştırıyor mu?
Kesinlikle.
Ama:
Reverse engineering bilgisini tamamen gereksiz hale getirmiyor.
Agent yanlış fonksiyonu takip edebilir.
Decompiler yanlış pseudocode üretebilir.
Obfuscation analizi zorlaştırabilir.
Runtime davranış ile statik analiz farklı sonuç verebilir.
Server-side bir sistem binary'nin içinde bulunmayabilir.
Anti-debug mekanizmaları olabilir.
Bir uygulamanın davranışını anlamak hâlâ hipotez kurmayı ve doğrulamayı gerektiriyor.
Fakat eskiden saatler sürebilecek:
string bul
↓
xref bul
↓
fonksiyona git
↓
caller bul
↓
assembly incele
↓
başka fonksiyon
iş akışının önemli bir kısmını agent'ın üstlenebilmesi büyük fark yaratıyor.
Bence REA'nın Asıl Önemi
Coding agent'ların gelişiminde birkaç aşama gördük.
İlk aşama:
AI
↓
Kod yazıyor
Sonra:
AI
↓
Projeyi okuyor
↓
Kod değiştiriyor
Agent sistemleriyle:
AI
↓
Terminal kullanıyor
↓
Test çalıştırıyor
↓
Browser kullanıyor
Şimdi REA'nın getirdiği fikir:
AI
↓
Kaynak kodu olmayan yazılımı
inceleyebiliyor
Bu oldukça büyük bir sınır değişimi.
Çünkü dünyadaki yazılımların çoğunun kaynak koduna sahip değiliz.
Ama binary'sine veya çalışan uygulamasına sahibiz.
Yazılımı Koruma Tarafında Ne Anlama Geliyor?
REA gibi sistemler yaygınlaştıkça client tarafında bulunan kodun:
“Kimse bunu anlamaz.”
diye korunması giderek daha zayıf bir strateji haline geliyor.
Bu aslında yeni bir durum değil.
Reverse engineering yıllardır mümkün.
Fakat AI agent'lar işin maliyetini azaltıyor.
Daha önce:
uzman
+
Ghidra
+
saatler/günler
gerektiren bazı araştırmalar artık:
coding agent
+
REA
+
analiz araçları
ile çok daha erişilebilir hale geliyor.
Bu nedenle:
- API secret'ları,
- kritik business logic,
- özel güvenlik kuralları,
- erişim anahtarları
mümkün olduğunca client tarafına güvenilerek korunmamalı.
Bu zaten yıllardır doğru güvenlik yaklaşımıydı.
REA sadece neden doğru olduğunu tekrar hatırlatıyor.
Hukuki Taraf
Reverse engineering'in hukuki durumu ülkeye, yazılım lisansına ve yapılan işin amacına göre değişebiliyor.
REA projesinin kendisi de aracın:
- yasal araştırma,
- eğitim,
- interoperability,
- software preservation,
- yetkili güvenlik araştırması
gibi amaçlarla kullanılmasını öngördüğünü belirtiyor.
Bir yazılımı nasıl çalıştığını öğrenmek ile başkasının ürününü birebir kopyalayıp ticari olarak dağıtmak aynı konu değil.
Özellikle ticari yazılımlarda lisans ve kullanım şartlarına dikkat etmek gerekiyor.
Sonuç
REA'ya ilk baktığınızda:
“AI artık her programın kaynak kodunu çıkarıyor.”
gibi bir izlenim oluşabilir.
Aslında teknoloji daha ilginç.
REA yeni bir Ghidra değil.
Yeni bir decompiler da değil.
Ghidra'nın başına AI oturtuyor.
Eskiden:

İnsan
↓
Reverse Engineering Tool
↓
Binary
Şimdi:
İnsan
↓
AI Agent
↓
REA
↓
Reverse Engineering Tools
↓
Binary
Ve bence asıl kırılma burada.
Coding agent'lar bugüne kadar büyük ölçüde kaynak kodu olan dünyada çalışıyordu.
REA ise onların önüne başka bir kapı açıyor:
Kaynak kodu olmayan yazılımlar.
Bugün Claude Code'a:
“Bu uygulama nasıl çalışıyor?”
diye sorduğunuzda model tahmin etmek zorunda kalmayabilir.
Gidip kendisi inceleyebilir.
Belki birkaç yıl sonra reverse engineering araçlarının en büyük kullanıcıları insanlar değil...
AI agent'lar olacak.
Yorumlar 00
Yorumlar onaylandıktan sonra yayınlanır. E-posta adresin hiçbir yerde gösterilmez.